与上海交通大学网络空间安全团队联合研发
模型安全只是起点,Agent 安全才是全部
六大检测模块,覆盖从基础设施到工作流的完整攻击面
围绕 Agent 真实攻击面设计,从网络暴露面一直查到工作流行为
发现 AI 服务、组件、版本、网络暴露面和基础配置风险。
分析 MCP Server 的工具、资源、协议配置、源码风险与运行行为。
审计 Skill 声明、脚本、依赖和敏感行为,识别九类供应链与代码执行风险。
检查 Agent Card、声明端点、能力描述、协议规范和身份仿冒风险。
评估目标模型在不同风险场景和攻击技术下的安全响应能力。
通过真实交互检测工具滥用、数据泄露、间接注入和授权绕过。
从选择任务类型到风险报告输出的标准化闭环
六类检测模块按需组合,也可单模块专项扫描
填写服务地址、上传源码压缩包或声明端点
规则匹配与语义分析并行,实时查看进度与日志
对疑似风险二次复核,降低误报提高置信度
输出风险概况、证据明细与处置建议
当 AI 从聊天框走进业务系统,风险的性质已经变了
模型安全不等于 Agent 安全。Agent 会调用工具、访问数据、编排多步流程,攻击面从"说错话"扩展到"做错事",需要专门的检测方法。
MCP 与 A2A 让 Agent 可以接入任意外部能力,但工具声明、资源权限、第三方 Skill 依赖都可能成为入口。这类风险常规渗透测试和模型评测都覆盖不到。
开发期扫源码、审 Skill 依赖;上线前压越狱与工作流;上线后对已部署服务做周期性复核。同一套平台覆盖 AI 应用全生命周期。
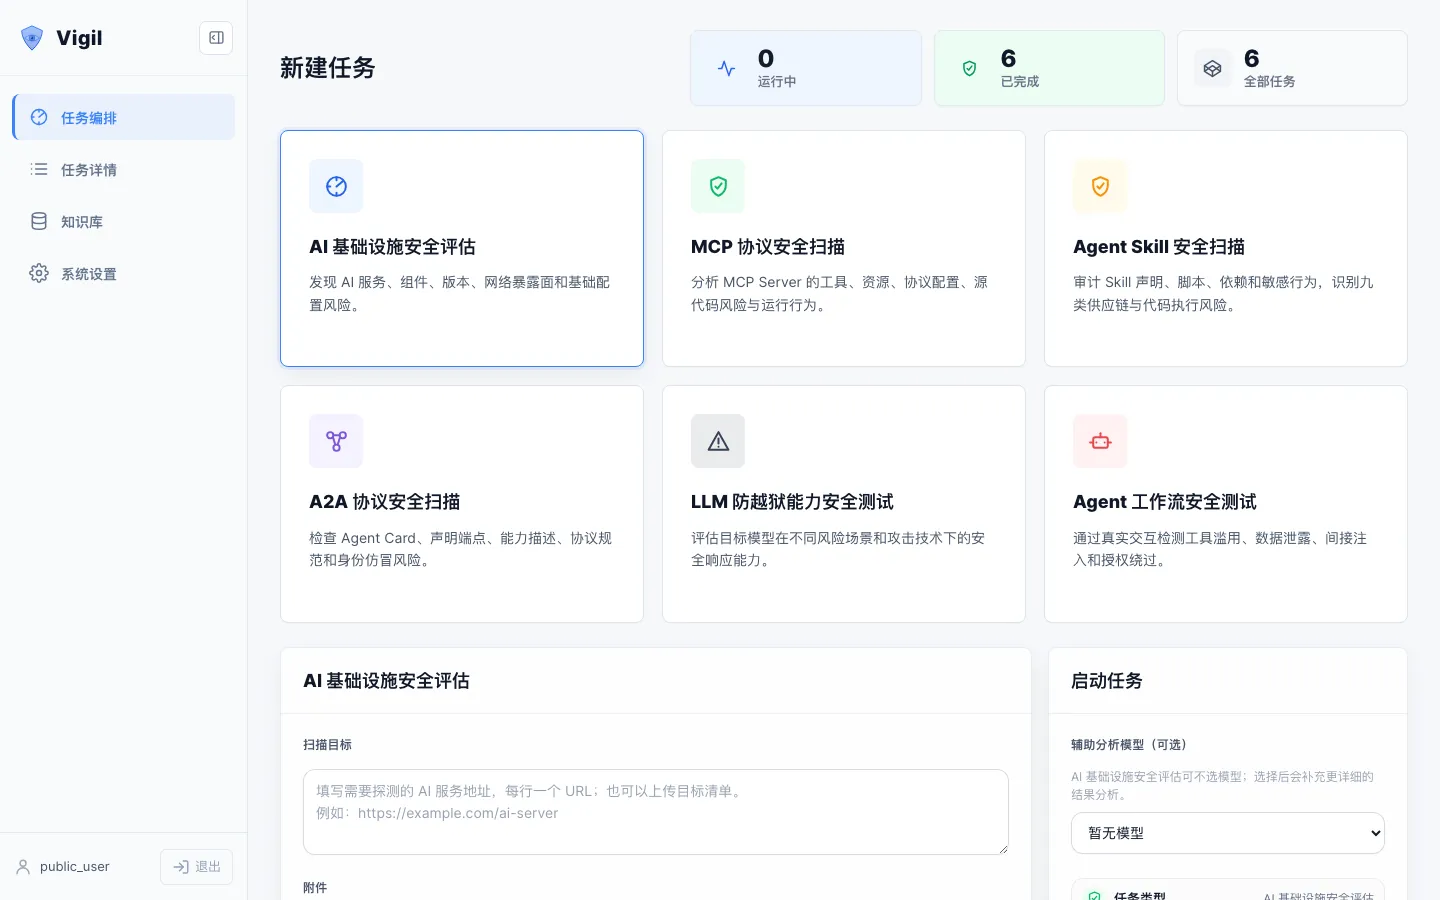
Vigil 以"任务"为核心组织安全检测:选择检测模块、配置检测对象、启动扫描,平台自动完成规则匹配与语义分析,将风险按等级归类并给出处置建议。检测结果与证据统一沉淀,支持历史任务回溯与结果报告导出。
凡跑 Agent 的团队,都需要回答同一组安全问题
Agent 上线前做一次完整安全体检,把风险拦在发布之前
对内部已上线的 AI 服务做持续的安全监测与风险复核
自查自研 MCP Server 与 Skill 的协议配置与代码风险
高安全内网环境下,对 AI 资产做不出域的本地化检测
Vigil 由数卓与上海交通大学网络空间安全团队(AI 安全方向)联合研发。学术团队提供 Agent 安全检测方法论与攻击技术研究支撑,数卓负责平台工程化与企业级交付,检测能力随研究成果持续更新。
AI 安全学术背书
方法论与研究支撑
攻击技术共建
越狱 / 注入 / 混淆手法持续更新
工程化交付
私有化部署与企业定制